[TOC]
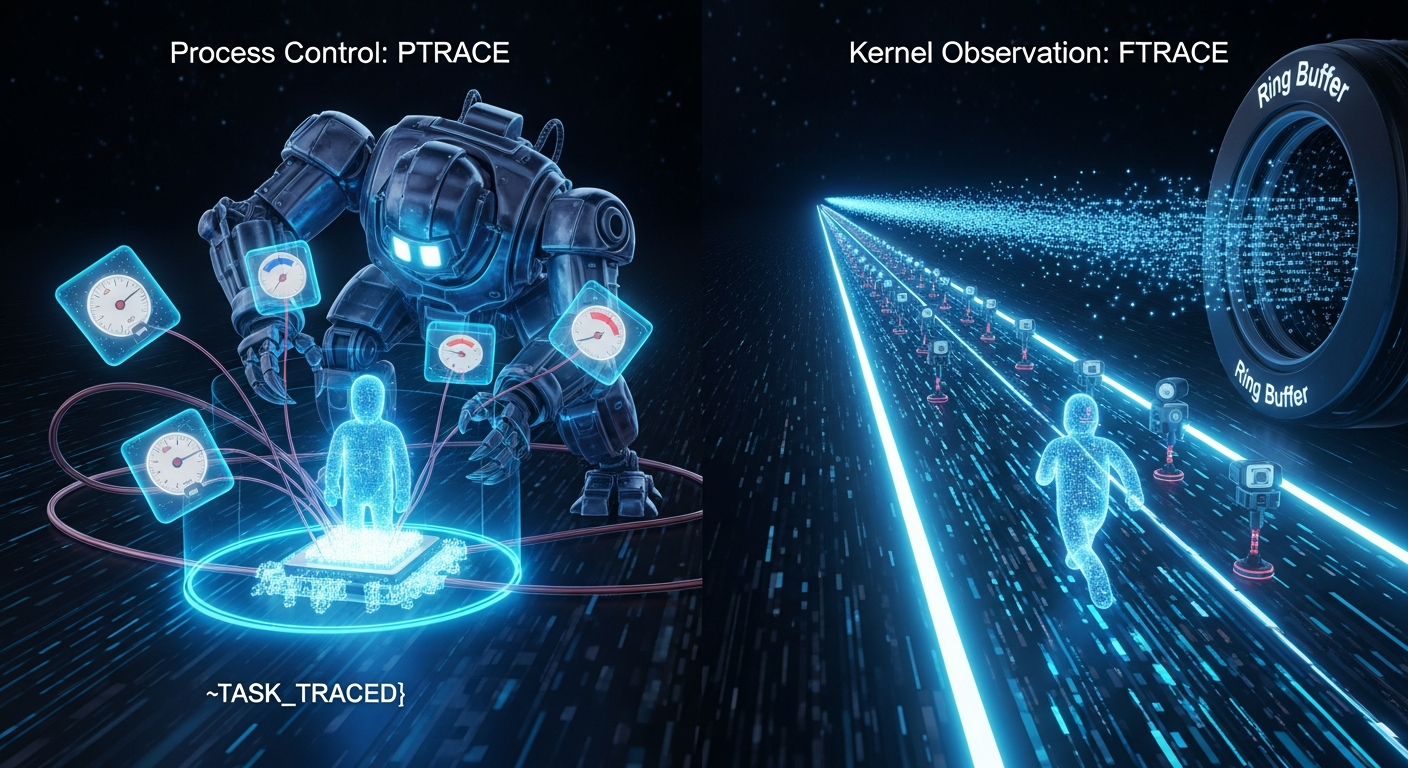
include/linux/ptrace.h 进程跟踪(Process Tracing) 定义调试器与内核交互的接口
历史与背景
这项技术是为了解决什么特定问题而诞生的?
include/linux/ptrace.h 是Linux内核中定义 ptrace() 系统调用接口的头文件。这项技术本身(ptrace,即Process Trace)的诞生,是为了解决一个根本性的需求:允许一个进程(tracer,跟踪者)去观察和控制另一个进程(tracee,被跟踪者)的执行。
在没有ptrace的情况下,一个进程的内部状态(寄存器、内存、执行流)对其他进程是完全封闭的,这是操作系统提供的基本隔离性保证。然而,为了实现以下关键功能,必须有一种受控的机制来打破这种隔离:
- 调试(Debugging):像GDB这样的调试器需要能够暂停目标进程、检查其寄存器和内存、设置断点、单步执行代码以及修改其状态。
ptrace提供了实现所有这些功能的核心原语。 - 追踪(Tracing):像
strace这样的工具需要能够拦截目标进程的每一次系统调用,并检查其参数和返回值,以分析其与内核的交互。ptrace也为此提供了专门的模式。 - 动态分析与沙箱(Dynamic Analysis & Sandboxing):一些安全工具或分析工具需要监控一个进程的行为,例如,限制其可以执行的系统调用,或者在执行特定代码时进行干预。
ptrace.h 文件本身的作用,就是将ptrace()系统调用的所有请求码(PTRACE_ATTACH, PTRACE_SYSCALL等)、相关的数据结构和常量,以标准化的方式暴露给内核的其他部分以及最终的用户空间程序。
它的发展经历了哪些重要的里程碑或版本迭代?
ptrace 是一个源自早期Unix的古老API,其在Linux中的发展也经历了一个不断增强的过程。
- 基本功能:最初的
ptrace提供了最基本的功能,如附加(attach)到一个进程、读写其内存和寄存器(PTRACE_PEEKTEXT,PTRACE_POKEDATA等)。 - 系统调用追踪:
PTRACE_SYSCALL的引入是一个重要的里程碑,它使得strace这类工具的实现成为可能。它允许tracer在tracee每次进入和退出系统调用时都被唤醒。 - 更健壮的附加机制:传统的
PTRACE_ATTACH存在一些竞争条件(race condition)方面的问题。后来引入的PTRACE_SEIZE、PTRACE_INTERRUPT和PTRACE_LISTEN提供了一套更强大、更可靠的附加和事件监听机制,允许多线程的tracer更好地管理tracee。 - 安全性增强:由于
ptrace的强大能力,它也带来了安全风险(例如,恶意软件附加到其他进程窃取数据)。为了应对这一点,内核引入了多种安全限制。最著名的是YAMA安全模块,它可以限制ptrace的作用域,例如,只允许父进程ptrace子进程。 - 扩展功能:随着内核的发展,
ptrace增加了许多新的请求来获取更详细的信息,例如获取VFP寄存器状态(PTRACE_GETVFPREGS)或设置seccomp策略(PTRACE_SECCOMP_GET_FILTER)。
目前该技术的社区活跃度和主流应用情况如何?
ptrace 是Linux进程管理ABI(应用程序二进制接口)中一个极其核心和稳定的部分。
- 主流应用:它是所有主流调试器(GDB, LLDB)、追踪器(
strace,ltrace)、以及一些逆向工程和动态插桩工具的技术基石。没有ptrace,这些关键的开发者工具将无法在Linux上工作。 - 社区活跃度:虽然其核心API非常稳定,但社区仍在不断地对其进行维护,修复bug,并为新的CPU架构或内核特性添加支持。关于其安全性的讨论和加固也是一个持续的话题。
核心原理与设计
它的核心工作原理是什么?
ptrace 的核心是一个由内核居中协调的**“ tracer-tracee ”**模型。ptrace.h 定义了这个模型交互的规则。
- 建立关系:一个进程(tracer)通过调用
ptrace(PTRACE_ATTACH, tracee_pid, ...)或启动一个子进程并调用ptrace(PTRACE_TRACEME, ...),来与另一个进程(tracee)建立追踪关系。 - 进入追踪状态:一旦关系建立,tracee就会进入一个特殊的状态(
TASK_TRACED)。 - 停止与通知:当tracee遇到一个“感兴趣的事件”时(例如,收到一个信号、进入/退出系统调用、执行完一条指令),它的执行会被内核暂停。同时,内核会通知正在
waitpid()中等待的tracer进程,并告知其tracee停止的原因。 - 检查与控制:被唤醒的tracer现在拥有了对已暂停的tracee的控制权。它可以通过调用
ptrace()并传入ptrace.h中定义的各种请求码,来执行以下操作:PTRACE_GETREGS/PTRACE_SETREGS: 读取/修改CPU寄存器。PTRACE_PEEKDATA/PTRACE_POKEDATA: 读取/修改tracee的内存。PTRACE_CONT: 让tracee继续执行。PTRACE_SINGLESTEP: 让tracee只执行一条指令然后再次停止。PTRACE_SYSCALL: 让tracee继续执行直到下一次系统调用入口或出口。
- 恢复执行:tracer在完成检查和修改后,会调用
ptrace(PTRACE_CONT, ...)等命令让tracee恢复执行,然后tracer自己再次进入waitpid()等待下一次事件的发生。
它的主要优势体现在哪些方面?
- 强大的控制力:提供了对目标进程近乎完全的底层控制,是实现调试器的基础。
- 通用性:一个统一的API接口被用于多种不同的任务(调试、追踪、分析)。
- API层面的架构无关性:尽管底层实现(如寄存器集的布局)是与CPU架构相关的,但
ptrace()系统调用和请求码本身是通用的内核ABI。
它存在哪些已知的劣势、局限性或在特定场景下的不适用性?
- 性能开销巨大:每次事件发生,都会涉及两次上下文切换(tracee -> kernel -> tracer -> kernel -> tracee)。这使得被
ptrace的进程运行速度极其缓慢,因此它完全不适用于生产环境中的高性能监控。 - API复杂且易错:
ptrace的API,特别是信号处理和多线程程序的追踪,非常复杂,存在很多微妙的竞争条件,正确使用它具有相当大的挑战性。 - 安全风险:其强大的能力使其成为一个潜在的安全漏洞。恶意程序可以利用它来注入代码、窃取密码等。因此,生产系统通常会对其使用进行限制。
- 一对一关系:一个进程在同一时间只能被一个进程
ptrace。
使用场景
在哪些具体的业务或技术场景下,它是首选解决方案?
在需要主动控制和修改另一个进程的执行流和状态时,ptrace是唯一且首选的解决方案。
- 交互式调试器 (GDB, LLDB):设置断点(通过
PTRACE_POKEDATA向代码中写入trap指令)、单步执行(PTRACE_SINGLESTEP)、检查变量值(PTRACE_PEEKDATA)等。 - 系统调用追踪器 (
strace):使用PTRACE_SYSCALL来拦截每一次系统调用,并使用PTRACE_GETREGS来获取参数。 - 代码覆盖率工具:可以通过单步执行或设置断点来分析哪些代码路径被执行了。
- 动态二进制插桩:高级工具使用
ptrace附加到一个运行中的程序,向其内存中注入新的代码,并修改其执行路径以调用这些新代码。
是否有不推荐使用该技术的场景?为什么?
- 高性能监控和追踪:绝对不推荐。因为其巨大的性能开銷会完全扭曲程序的正常性能表现。对于这类需求,应使用eBPF、perf_events或ftrace等内核原生的、低开销的追踪技术。
- 简单的进程间通信 (IPC):
ptrace是用于控制而非通信的。应使用管道、套接字、共享内存等标准IPC机制。
对比分析
请将其 与 其他相似技术 进行详细对比。
ptrace是用于主动控制的,而现代内核追踪技术则专注于高效观察。
| 特性 | ptrace |
eBPF (extended Berkeley Packet Filter) | perf_events | ftrace / kprobes |
|---|---|---|---|---|
| 主要用途 | 调试和控制用户空间进程。 | 可编程、高性能的内核/用户空间事件追踪与分析。 | 性能计数器采样和简单的事件追踪。 | 内核函数的追踪和探测。 |
| 性能开销 | 非常高。涉及大量上下文切换。 | 非常低。在内核中直接执行经过验证的、安全的字节码。 | 低。主要由硬件性能计数器支持。 | 低。内核内部的直接函数调用。 |
| 能力 | 读/写内存和寄存器,修改执行流。 | 只读内核和用户空间内存,不能修改执行流。 | 主要是计数和采样。 | 只读内核数据。 |
| 灵活性 | API固定,但功能强大。 | 高度可编程,可以在内核中实现复杂的过滤和聚合逻辑。 | 相对固定,主要用于预定义的硬件/软件事件。 | 用于探测内核函数,灵活性中等。 |
| 安全性 | 风险高。强大的能力是潜在的安全漏洞。 | 安全。eBPF程序在加载前会经过内核验证器检查,确保其不会崩溃或破坏内核。 | 安全。 | 安全,但编写内核模块有风险。 |
| 适用场景 | GDB, strace。 | 复杂的系统性能分析、网络监控、安全审计。 | CPU性能分析(如火焰图)、硬件事件监控。 | 内核开发者调试内核行为。 |
PT_EVENT_FLAG
1 |
|
1 | /** |
arch/arm/kernel/ptrace.c
break_trap 和 ptrace_break: 处理软件断点陷阱的核心函数
这两段代码构成了Linux内核在ARM架构上处理软件断点(Software Breakpoint)的核心逻辑。当CPU因为执行一条断点指令而陷入内核时,break_trap函数会被内核的异常处理框架调用。它的唯一工作是调用ptrace_break,而ptrace_break则负责向触发断点的进程发送一个SIGTRAP信号。这套机制是所有基于ptrace的调试工具(如gdb)能够工作的基石。
对于STM32H750 ARMV7M架构,这套机制的工作原理完全相同且至关重要。当你在使用J-Link或ST-Link通过gdb调试一个运行在STM32上的Linux用户空间程序时:
- 你在
gdb中设置一个断点。gdb会通过ptrace系统调用,将目标地址的原始指令替换为一条BKPT(断点)指令。 - 当你的程序执行到这个地址时,STM32H750的Cortex-M7核心会触发一个“调试监控”(DebugMonitor)或“未定义指令”(Undefined Instruction)异常,进入内核态。
- 内核的异常处理流程通过之前注册的钩子,最终调用
break_trap(regs, instr)。 break_trap调用ptrace_break(regs)。ptrace_break向你的用户空间程序发送SIGTRAP信号。- 这个信号会被内核的信号处理机制拦截,因为你的程序正处于被
ptrace跟踪的状态。内核会暂停你的程序,并通知调试器(gdb)。 gdb接收到通知后,会恢复被断点指令替换的原始指令,向你显示当前程序的状态(寄存器值、内存等),并等待你的下一步命令。
这个流程使得在嵌入式Linux系统上进行应用程序级的源码调试成为可能。
1 | /* |
ptrace_break_init: 注册ARM软件断点陷阱
此代码段的核心作用是在Linux内核启动的早期,为ARM架构设置软件断点(Software Breakpoint)的处理机制。它通过“钩子”(hook)的形式,挂接到内核的“未定义指令”(Undefined Instruction)异常处理流程中。当一个程序(通常在调试器gdb的控制下)执行一条特定的断点指令时,CPU会触发一个异常。这段代码确保内核能捕获这个异常,并调用相应的处理函数(break_trap),而不是让系统崩溃。这套机制是ptrace系统调用和调试器功能的基础。
对于STM32H750 ARMV7M架构,这个机制至关重要,但需要特别注意其指令集:
- ARMv7-M架构只支持Thumb-2指令集。它不能执行传统的32位ARM指令。
- 因此,在这三个钩子中,
arm_break_hook是无关的,因为它用于匹配ARM状态下的断点指令,而STM32H750的CPU永远不会处于ARM状态(其CPSR寄存器的T位永远是1)。 thumb_break_hook和thumb2_break_hook是相关的,它们分别用于捕获16位和32位的Thumb断点指令,这两种指令在ARMv7-M架构中都可能遇到。core_initcall确保了这个断点处理机制在内核非常早期的阶段就被建立起来,以便内核自身的早期调试成为可能。
1 | /* |
kernel/trace Linux内核追踪框架(Linux Kernel Tracing Framework) 动态、低开销的内核观测平台
历史与背景
这项技术是为了解决什么特定问题而诞生的?
kernel/trace 目录下的代码构成了Ftrace,即Linux内核的官方追踪框架。它的诞生是为了解决内核开发者和系统性能分析师面临的一个核心挑战:如何在不显著影响系统性能、不停止系统运行的前提下,获得对内核内部行为的精确、详细的观察。
在Ftrace出现之前,内核调试和分析主要依赖以下几种方式,但它们都有严重缺陷:
printk:虽然简单易用,但它是一个高开销的操作,涉及锁、字符串格式化和控制台输出。在高性能路径中大量使用printk会严重扭曲程序的时序,甚至导致系统性能急剧下降。- 调试器 (KGDB):调试器功能强大,但它是一种侵入式工具。它会完全停止被调试的CPU或整个系统,这使得它无法用于分析与时序相关的、转瞬即逝的问题,如性能毛刺、偶发的延迟尖峰或实时系统中的竞争条件。
- 自定义内核模块:开发者可以编写自己的模块来收集信息,但这需要大量的样板代码,且有很高的风险(一个bug就可能导致内核崩溃)。
Ftrace的诞生就是为了提供一个低开销、非侵入式、安全且高度灵活的内核追踪基础设施,让开发者能够动态地“探查”内核的内部运作,就像用逻辑分析仪观察硬件信号一样。
它的发展经历了哪些重要的里程碑或版本迭代?
Ftrace由著名的实时Linux开发者Steven Rostedt创建,并从一个简单的工具演变成了一个庞大而强大的框架。
- 延迟追踪器(Latency Tracer):Ftrace的起源是为了调试实时内核中的非预期高延迟。
irqsoff和preemptoff等追踪器就是为了找出内核中禁止中断或抢占时间过长的代码路径。 - 函数追踪器(Function Tracer):这是Ftrace最著名的功能之一。通过内核编译时在几乎所有函数的入口处插入一个微小的钩子(mcount),Ftrace可以动态地开启对内核函数调用的追踪,而开销极低。
- 环形缓冲区(Ring Buffer):为了实现高性能,Ftrace实现了一个非常高效的、大部分情况下无锁的per-CPU环形缓冲区。这使得追踪事件可以被极快地写入内存,而不会阻塞正在被追踪的代码的执行。
- Tracepoints的引入:这是一个决定性的里程碑。Tracepoints是由内核开发者在代码的关键位置手动放置的、静态的、稳定的追踪钩子。相比于动态的kprobes,它们开销更低、ABI更稳定。这使得Ftrace从一个调试工具演变成了一个可用于生产环境的分析工具。
- 成为通用框架:Ftrace的环形缓冲区和事件格式化系统被设计得非常通用,使其成为了其他追踪工具的后端。例如,
perf命令的事件追踪部分(perf record -e ...)就是将事件写入Ftrace的环形缓冲区。 - Tracer插件化:Ftrace发展出了一个插件式的架构,允许加载不同的“tracer”(如
function_graph、sched_switch等)来对数据进行不同的处理和呈现。
目前该技术的社区活跃度和主流应用情况如何?
Ftrace是Linux内核中最核心的性能分析和调试基础设施之一。
- 主流应用:
- 性能分析:用于分析延迟来源、寻找性能瓶颈、理解复杂的内核交互。
- 内核调试:用于理解bug的成因,追踪事件发生的顺序。
- 是
perf和eBPF的基础:perf使用Ftrace作为其事件追踪后端。许多eBPF程序也选择挂载在Ftrace的tracepoint上,因为它们是稳定且高效的事件源。 - Android / ChromeOS:在这些系统中,Ftrace被广泛用于性能分析和功耗优化。
核心原理与设计
它的核心工作原理是什么?
Ftrace是一个多组件协同工作的复杂系统,其核心可以概括为**“探针(Probes) -> 环形缓冲区(Ring Buffer) -> 用户接口(User Interface)”**。
探针 (Probes) - 数据来源:
- 静态Tracepoints:内核代码中预设的、最高效的探针。例如,在
kernel/sched/core.c中有trace_sched_switch(),当进程切换时就会被触发。 - 动态Kprobes/Uprobes:允许在运行时动态地在内核或用户空间的几乎任何指令地址上放置一个探针。更灵活,但开销稍高。
- 函数追踪:利用编译器在函数入口处留下的
mcount调用点,动态地将nop指令替换为追踪函数的调用。
- 静态Tracepoints:内核代码中预设的、最高效的探针。例如,在
环形缓冲区 (Ring Buffer) - 高效的数据存储:
- 这是Ftrace的性能核心。每个CPU都有一个独立的环形缓冲区。
- 写入操作通常是无锁的,只是原子地更新指针,这使得追踪对被测系统的性能影响降到最低。
- 它允许多个“读者”(如
cat /sys/.../trace)和一个“写入者”(内核)并发操作而互不阻塞。 - 实现了覆写模式:当缓冲区满时,新的事件会自动覆盖最旧的事件。这对于捕捉罕见事件前的“最后时刻”非常有用。
Tracer插件 - 数据的处理与呈现:
- 用户可以选择一个“tracer”来控制如何处理和格式化追踪数据。
nop:默认tracer,只记录通过tracepoint触发的事件。function:记录所有被调用的内核函数名。function_graph:不仅记录函数调用,还记录其返回,并以一种类似C源码的缩进格式呈现函数调用图和执行时间。sched_switch:只关注进程上下文切换事件。irqsoff/preemptoff:追踪并记录禁止中断/抢占时间最长的代码路径。
用户接口 (
debugfs):- Ftrace的所有控制和输出都通过
debugfs文件系统下的一个目录(通常是/sys/kernel/debug/tracing/)进行。用户通过读写这些“普通”文件来控制追踪:echo function > current_tracer:选择一个tracer。echo 1 > tracing_on:开始/停止追踪。cat trace:读取追踪结果。echo sched:sched_switch > set_event:只开启某个特定的tracepoint事件。
- Ftrace的所有控制和输出都通过
它的主要优势体现在哪些方面?
- 极低的开销:其设计目标之一,使得它可以在生产环境中使用。
- 动态性:无需重新编译或重启,即可在运行时动态地开启、关闭和配置。
- 灵活性和强大功能:提供了多种追踪器和事件源,可以从不同维度深入分析内核。
- 安全性:作为内核的一部分,它比自定义模块更安全、更稳定。
它存在哪些已知的劣势、局限性或在特定场景下的不适用性?
- 原始的UI:基于
debugfs的文本接口虽然强大,但使用起来非常繁琐。因此社区开发了trace-cmd等工具来简化其使用。 - 海量数据:开启函数追踪等功能会瞬间产生巨量的追踪数据,需要有效的过滤和后处理。
- 缺乏复杂的在核内分析能力:Ftrace主要负责记录事件。它不能像eBPF那样,在内核中对事件流进行复杂的编程、过滤、聚合和状态维持。
使用场景
在哪些具体的业务或技术场景下,它是首选解决方案?
Ftrace是获取内核事件的原始、高保真时间序列的首选方案。
- 分析延迟毛刺:使用
function_graph追踪器,并设置过滤器,可以精确地看到在一个高延迟的请求中,内核到底在哪个函数里花费了多长时间。 - 理解子系统交互:要理解一个磁盘I/O请求从提交到完成的全过程,可以开启所有与
block,ext4,scsi相关的tracepoint,然后观察事件发生的顺序和时间戳。 - 调试竞争条件:通过追踪
sched_switch和lock相关的事件,可以分析多个线程的交错执行顺序,从而找到问题的根源。
是否有不推荐使用该技术的场景?为什么?
- 长期的、聚合性的性能监控:如果你想监控整个系统长达数小时的平均CPU使用率或磁盘IOPS,Ftrace不是合适的工具。它产生的是原始事件流,而不是聚合后的统计数据。这种场景应使用
sar、Prometheus Node Exporter等。 - 主动控制进程:Ftrace是一个观察工具,不是控制工具。要暂停、修改一个进程,应使用调试器和
ptrace。
对比分析
请将其 与 其他相似技术 进行详细对比。
| 特性 | Ftrace | printk |
perf |
eBPF |
|---|---|---|---|---|
| 主要用途 | 获取原始事件流,进行详细的底层行为和时序分析。 | 简单的文本日志记录,用于低频事件和错误报告。 | 性能统计和采样,找出性能热点(“火焰图”)。 | 可编程的内核追踪,可在内核中进行复杂的事件过滤、聚合和状态维持。 |
| 开销 | 低。 | 高。 | 低(采样模式),中等(追踪模式,后端是Ftrace)。 | 低(JIT编译的字节码)。 |
| 数据格式 | 格式化的文本事件流。 | 自由文本。 | 统计报告或二进制样本文件。 | 可编程的,可以是聚合的哈希表、直方图或事件流。 |
| 在核内逻辑 | 固定(由tracer插件决定)。 | 无。 | 固定(计数、采样)。 | 完全可编程。 |
| 灵活性 | 高(多种tracer和事件)。 | 低。 | 中(多种事件和采样模式)。 | 极高(图灵完备的子集)。 |
| 适用场景 | “这个I/O请求为什么花了50ms?” | “我的驱动初始化失败了,为什么?” | “我的程序中哪个函数消耗了最多的CPU时间?” | “统计所有返回错误码的open系统调用,并按进程名和文件名聚合。” |
kernel/trace/trace_branch.c
ftrace_likely_data 分支预测数据结构
1 | struct ftrace_branch_data { |
branch_tracing_enabled 分支追踪使能状态
1 | // #define __read_mostly __section(".data..read_mostly") |
branch_trace_init 分支追踪初始化 使能 禁用 重置
1 | void disable_branch_tracing(void) |
trace_likely_condition probe_likely_condition 追踪可能的条件 (未完成分析)
1 | static inline |
ftrace_likely_update 追踪可能的预测更新
1 | void ftrace_likely_update(struct ftrace_likely_data *f, int val, |
 微信
- 支付寶