ROS教程09:从 CallbackQueue 追到 Spinner——Callback 执行、阻塞与 roscpp 线程模型
摘要:沿 CallbackQueue 与 Spinner 源码主线,结合真实阻塞、并发与自定义队列日志,解释 callback 的执行线程、串行边界、适用场景与驱动线程模型。
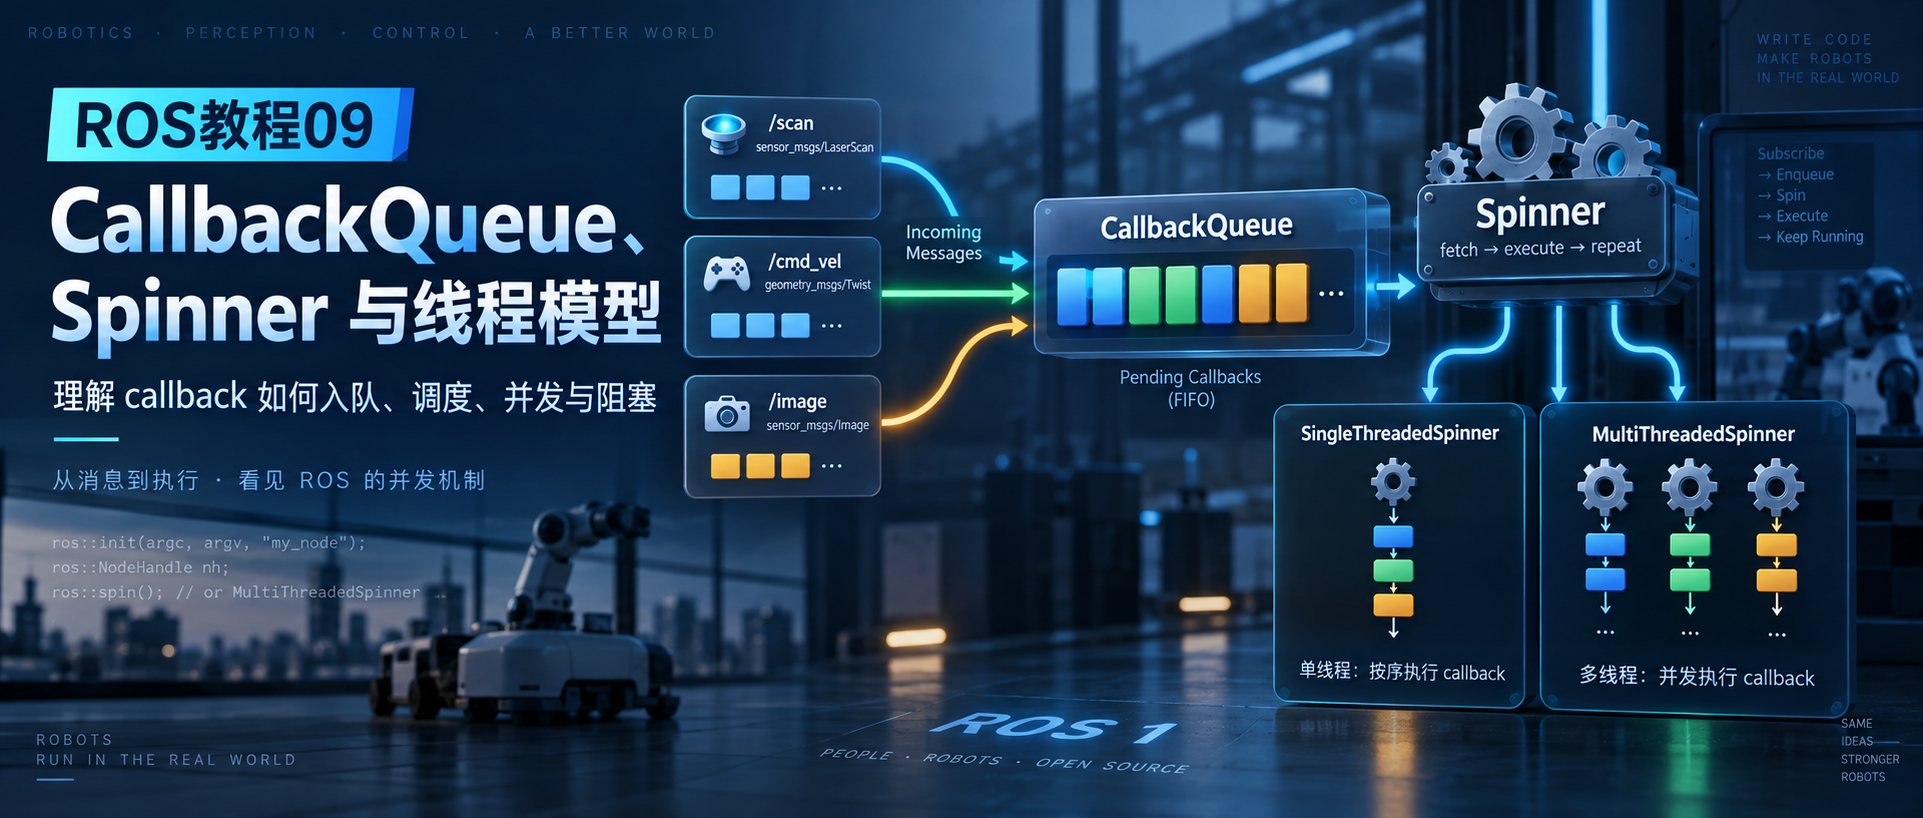
@[toc]
第 08 章已经把一条 TCPROS 消息追到 Subscriber 侧:网络线程完成收包和组帧以后,消息进入 Subscription::handleMessage(),随后由 SubscriptionQueue 和 CallbackQueue 接管。到那里为止,还没有回答一个对驱动开发非常关键的问题:
消息已经到达当前进程以后,用户 callback 为什么是在现在执行、由哪个线程执行;一个 callback 阻塞以后,又会拖住谁?
第 09 章只围绕这个问题展开。主线从第 08 章的终点继续,不再重复 Master、XML-RPC、TCPROS Header、序列化和 Socket 收发。
本章使用新的实验 package:
1 | ros_ws/src/ros1_comm_lab/ |
ros1_hello 继续作为最小 roscpp 入口;ros1_comm_lab 专门承载 queue、spinner、Service 和 Action 等通信机制实验。
本章用五组运行现象回答“到底哪里串行、哪里并发”:
| 实验 | 要确认的行为 |
|---|---|
spin + slow/fast |
单线程 Spinner 下,一个慢 callback 是否拖住其它 Subscription |
multi(2) + slow/fast |
两个不同 Subscription 是否可以由不同 worker 同时推进 |
multi(4) + allow=false |
多 worker 下,同一 Subscription 是否仍默认串行 |
multi(4) + allow=true |
同一 Subscription 是否会出现真实 callback 重叠 |
| Custom CallbackQueue | 一组 callback 阻塞时,另一调度域是否仍可继续执行 |
这五组实验不取代源码分析,而是用日志把源码中的线程与互斥关系变成可观察证据。
1. 从第 08 章继续:网络线程并不直接调用业务 callback
第 08 章已经确认,TCPROS 数据到达 Subscriber 后,主路径会进入:
1 | TransportPublisherLink::onMessage() |
Subscription::handleMessage() 中与本章直接相关的代码可以压缩成:
1 | info->subscription_queue_->push( |
这里同时出现了两个名字非常接近、但职责完全不同的对象:
| 对象 | 当前职责 |
|---|---|
SubscriptionQueue |
保存某个 subscription 尚未被业务 callback 消费的消息 |
CallbackQueue |
保存待调度的 CallbackInterface 工作项;ready() 决定当前是否可执行 |
queue_size 首先约束的是 SubscriptionQueue 中的待处理消息数量。队列已满时,SubscriptionQueue::push() 会丢弃最旧消息,再压入新消息。
而 CallbackQueue 不是消息 payload 队列。它保存的是 CallbackInterface 工作项;对普通 Subscriber 来说,这个工作项就是对应的 SubscriptionQueue。
因此第 08 章末尾的链路可以继续写成:
1 | TCPROS 完整消息 |
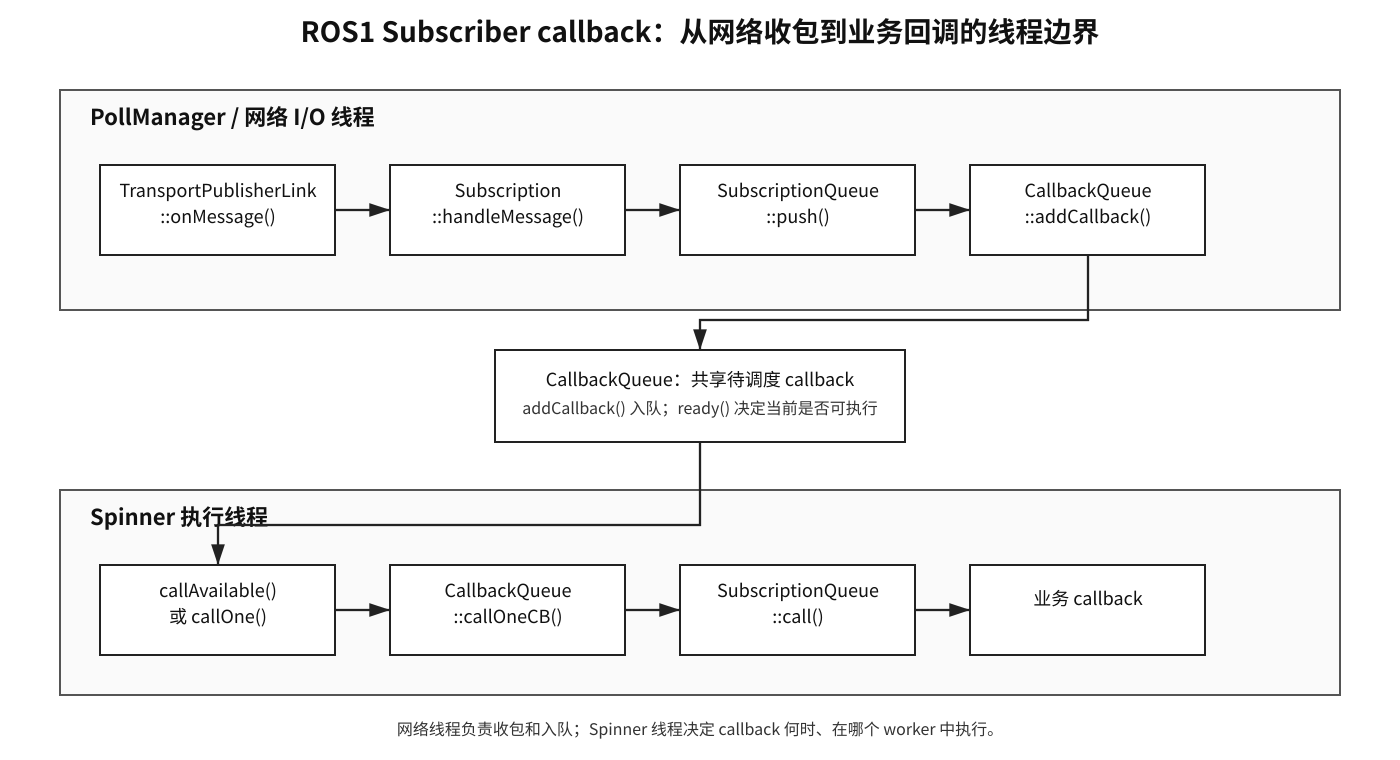
图中的边界非常重要:
1 | PollManager / 网络 I/O 线程 |
所以“rostopic echo 已经能看到数据”“Socket 已经收到数据”和“业务 callback 已经执行”是三个不同层次的事实。
本节小结: 网络 I/O 线程负责把 Subscriber 工作送入 callback 系统,真正的用户 callback 由后续 Spinner 执行;“消息已到达进程”和“callback 已执行”不是同一件事。
2. SubscriptionQueue::push():Subscriber 的 queue_size 到底约束什么
源码:
1 | ros_comm/clients/roscpp/src/libros/subscription_queue.cpp |
构造函数保存:
1 | SubscriptionQueue::SubscriptionQueue( |
当前实验中:
1 | nh.subscribe("/comm_lab/fast", 100, ...); |
或者 SubscribeOptions 中:
1 | slow_options.queue_size = 100; |
最终都会形成一个 SubscriptionQueue,其中:
1 | size_ = 100 |
当消息到达:
1 | if (fullNoLock()) |
因此 Subscriber 侧的 queue_size=100 不是:
1 | TCP receive buffer = 100 bytes |
也不是:
1 | CallbackQueue 最多 100 项 |
它首先表示:
这个 subscription 最多允许多少条已经到达、但还没有被用户 callback 消费的消息排队。
如果 callback 太慢,网络仍然可以继续收消息。SubscriptionQueue 最终可能到达上限,然后开始丢弃较老消息。
这也是为什么仅看到 TCPROS 连接稳定、网络无丢包,并不能证明业务 callback 没有丢 ROS message。
本节小结: Subscriber 的 queue_size 首先约束 SubscriptionQueue 中尚未被业务 callback 消费的消息数量;callback 太慢时,网络正常并不代表应用层不会丢旧消息。
3. CallbackQueue::addCallback():消息已经排队,但还没有开始执行
源码:
1 | ros_comm/clients/roscpp/src/libros/callback_queue.cpp |
addCallback() 主干:
1 | void CallbackQueue::addCallback( |
现在发生的是:
1 | 构造 CallbackInfo |
notify_one() 只是唤醒可能正在等待工作的 Spinner 线程,并不会在调用 addCallback() 的网络线程中直接执行用户 callback。
这一步结束后,消息仍处于“等待调度”状态。
本节小结: CallbackQueue::addCallback() 只负责登记和唤醒等待线程,不在网络线程里直接调用业务 callback。
4. callAvailable() 与 callOne():Spinner 消费 queue 的两种方式
CallbackQueue 对外最关键的两个消费入口是:
1 | callAvailable(timeout) |
两者不是同义函数。
4.1 callAvailable():一次转移当前 queue 中的一批 callback
主干逻辑:
1 | bool was_empty = tls->callbacks.empty(); |
也就是说,callAvailable() 会把当前共享 callbacks_ 中已有的工作移动到当前线程自己的 TLS callback 列表,然后持续调用 callOneCB()。这里不会先把整批工作按 ready() 过滤;如果某项在实际 call() 时返回 TryAgain,它会被重新放回共享 queue。
这里的 TLS 是 thread-local storage。不同 Spinner worker 拥有各自的 TLS 状态。
因此:
callAvailable()不是“只执行一条 callback”。
这一点对理解 ros::spinOnce() 非常重要。
4.2 callOne():只取一个当前 ready 的 callback
callOne() 会扫描共享 callbacks_,找到一个:
1 | info.callback->ready() |
为 true 的工作项,取出以后执行一次 callOneCB()。
因此多 worker 场景下,多个线程可以分别从同一个共享 CallbackQueue 中各取一个 ready callback。
4.3 callOneCB():真正进入 CallbackInterface::call()
无论前面来自 callAvailable() 还是 callOne(),最终都进入:
1 | result = cb->call(); |
普通 Subscriber 的 cb 实际指向 SubscriptionQueue,所以继续进入:
1 | SubscriptionQueue::call() |
如果 call() 返回:
1 | TryAgain |
CallbackQueue 会把该工作项重新放回共享 callbacks_,等待后续再尝试。
这个 TryAgain 正是理解“同一个 subscription 默认不能同时执行多个 callback”的关键入口。
本节小结: callAvailable() 倾向于让当前线程处理一批工作,callOne() 一次选择一个 ready 工作;二者最终都通过 callOneCB() 进入 CallbackInterface::call()。
5. SubscriptionQueue::call():反序列化和用户 callback 真正在 Spinner 线程发生
SubscriptionQueue::call() 一开始有一把:
1 | boost::recursive_mutex callback_mutex_; |
然后:
1 | boost::recursive_mutex::scoped_try_lock lock( |
默认:
1 | allow_concurrent_callbacks_ = false |
所以如果某个线程已经在执行这个 subscription 的 callback,另一个 worker 再尝试执行同一 SubscriptionQueue 时拿不到 callback_mutex_,就返回:
1 | TryAgain |
接下来函数从消息队列取一项:
1 | i = queue_.front(); |
随后才执行:
1 | VoidConstPtr msg = i.deserializer->deserialize(); |
反序列化成功后:
1 | i.helper->call(params); |
最终进入用户注册的:
1 | slowCallback(...) |
因此当前 TCPROS Subscriber 的线程链可以准确写成:
1 | PollManager thread |
这里得到本章第一个核心结论:
roscpp 的 Topic 网络 I/O 执行面与用户 callback 执行面是分开的。网络线程负责把工作送进 callback 系统,Spinner 决定业务 callback 什么时候执行。
本节小结: SubscriptionQueue::call() 是消息出队、反序列化、同 Subscription 并发约束和最终用户 callback 汇合的位置,也是理解 allow_concurrent_callbacks 的关键。
6. 先把实验跑起来:ros1_comm_lab 已完成构建验证
后面的线程结论不只来自源码阅读,还要用可重复的运行现象验证。实验 package 仍然使用:
1 | ros_ws/src/ros1_comm_lab/ |
在 ROS1 Noetic 环境中执行:
1 | cd /workspace/ros_ws |
实际构建日志已经确认该 package 可以正常编译。公开稿只保留与结论有关的行,用户名、主机名、PID、日志路径和 run id 均已移除:
1 | Starting >>> ros1_comm_lab |
本次实测环境中,roslaunch 输出还确认:
1 | /rosdistro: noetic |
spinner_lab 提供两个 Subscriber:
1 | /comm_lab/slow |
custom_queue_lab 另外提供:
1 | /comm_lab/driver |
后续命令需要在对应 roslaunch 仍处于运行状态时执行。否则 rostopic 找不到 ROS Master,会直接报:
1 | ERROR: Unable to communicate with master! |
这个错误与 Spinner 本身无关,因此不把它作为并发机制的实验结果。
本节小结: ros1_comm_lab 已实际构建通过,后续结论可以同时使用 Noetic 源码和真实运行日志交叉验证,而不是只依赖“预期现象”。
7. ros::spin():单线程不是“简单”,而是一种明确的串行执行模型
7.1 它到底怎么执行 callback
Noetic init.cpp:
1 | void spin() |
所以:
1 | ros::spin(); |
本质是创建:
1 | SingleThreadedSpinner |
SingleThreadedSpinner::spin() 再循环调用:
1 | queue->callAvailable(timeout); |
默认 queue 是:
1 | global CallbackQueue |
因此最常见的执行模型可以画成:
1 | main thread |
这里只有一条业务 callback 执行线程。
7.2 怎样使用
典型 Node:
1 | int main(int argc, char** argv) |
调用 ros::spin() 后,当前线程会一直留在 Spinner 中,直到 ROS shutdown。
如果希望显式使用 Spinner 类,也可以写成:
1 | ros::SingleThreadedSpinner spinner; |
对默认 global CallbackQueue 来说,这与 ros::spin() 建立的是同一种单线程 callback 执行模型。普通 Node 直接使用 ros::spin() 更简洁;显式类名主要用于需要把 Spinner 模型写得更清楚、或进一步传入指定 CallbackQueue 的场景。
因此它适合:
- callback 很短;
- callback 之间天然适合串行;
- Node 没有必须由 main thread 持续执行的其它工作;
- 希望共享状态尽量少引入线程同步。
7.3 不同 Subscription 也是串行的
启动实验:
1 | roslaunch ros1_comm_lab spinner_lab.launch \ |
另外两个终端发送:
1 | rostopic pub -r 0.2 \ |
1 | rostopic pub -r 5 \ |
下面是实际日志的脱敏节选。绝对时间戳和原始 thread id 被去掉,线程统一记作 T-main:
1 | [fast] EVENT call=20 data=1 thread=T-main |
这里最有价值的不是“日志停了 2 秒”,而是 slow END 后一批 fast callback 立即连续执行。
它说明:
1 | /fast 消息仍然可以继续到达进程 |
所以单线程 Spinner 下,一个耗时 callback 会影响同一个 CallbackQueue 中其它 Subscription 的 callback。
7.4 单线程 Spinner 的收益和代价
收益是执行关系简单:
1 | 同一时刻只有一个用户 callback 执行 |
许多共享状态可以依赖这个串行事实,而不必立刻引入 mutex。
代价也很明确:
1 | 一个 callback 阻塞 |
因此不要把数秒级阻塞 I/O、长时间图像处理或大计算直接塞进一个以 ros::spin() 为核心的 callback,除非这种阻塞就是期望的执行模型。
本节小结:
ros::spin()本质是SingleThreadedSpinner。- 默认消费 global CallbackQueue,并占用当前调用线程直到 shutdown。
- 不同 Subscription 之间也是串行的。
- 一个慢 callback 会推迟同 queue 上其它 callback。
- 适合 callback 短、顺序清晰、希望降低共享状态同步复杂度的 Node。
8. ros::spinOnce():把 callback 处理嵌入自己的主循环
Noetic 源码:
1 | void spinOnce() |
所以 spinOnce() 不是:
1 | 只执行一个 callback |
而是:
1 | 当前线程 |
8.1 常见用法
1 | ros::Rate rate(100.0); |
这个模式的价值是:main thread 可以显式控制:
1 | 应用逻辑 |
适合:
- 程序本来就有固定周期主循环;
- 希望 callback 处理点出现在确定的位置;
- main loop 中其它工作耗时可控。
8.2 为什么主循环耗时会直接影响 callback 延迟
假设:
1 | updateApplication() = 80 ms |
即使消息早已进入 CallbackQueue,也必须等主线程下一次执行到:
1 | ros::spinOnce(); |
才有机会执行。
如果主循环中再放:
1 | 阻塞式串口 read 2 s |
那么 ROS callback 也可能跟着等待接近 2 秒。
因此 spinOnce() 常见于“主动控制调度点”的程序,而不适合作为“把 callback 变成异步”的手段。
8.3 并发属性
单个 main thread 周期性调用 spinOnce() 时:
1 | worker 数量:1(就是当前调用线程) |
只有应用自己从多个线程并发调用 queue API 时,才会进入另一种并发模型;这不是普通 spinOnce() 主循环的推荐理解方式。
本节小结:
spinOnce()调用的是 global CallbackQueue 的callAvailable(),不是只处理一条 callback。- 它处理一轮后返回,适合需要自己控制 main loop 的程序。
- callback 延迟同时受 callback 本身和主循环其它工作影响。
- 单线程调用
spinOnce()时,callback 仍然是串行执行。
9. MultiThreadedSpinner:多个 worker 提供的是“并发能力”
9.1 Noetic 实现不是另一套调度器
spinner.cpp:
1 | void MultiThreadedSpinner::spin(CallbackQueue* queue) |
所以:
1 | MultiThreadedSpinner |
当 N > 1 时,AsyncSpinnerImpl::threadFunc() 使用:
1 | queue->callOne(timeout); |
多个 worker 可以分别从同一个 CallbackQueue 中取得 ready callback。
9.2 基本用法
1 | ros::MultiThreadedSpinner spinner(2); |
含义不是“所有 callback 自动并发”,而是:
当前 CallbackQueue 有两个 worker 可以执行工作。
9.3 不同 Subscription 可以并发
启动:
1 | roslaunch ros1_comm_lab spinner_lab.launch \ |
继续发送:
1 | rostopic pub -r 0.2 \ |
1 | rostopic pub -r 5 \ |
实际日志脱敏后:
1 | [fast] EVENT call=19 data=1 thread=T-worker-A |
这次 /slow 阻塞时,/fast 没有停。
执行关系已经变成:
1 | worker A |
因此可以确认:
不同 Subscription 的 callback 可以由不同 worker 同时执行。
这里要使用“可以并发”,而不是“必然并发”。是否真的同时运行,还取决于 callback 是否同时 ready、worker 是否空闲以及实际调度时机。
9.4 串行不代表固定线程亲和性
另一组只发送 /comm_lab/slow 的实测中出现:
1 | [slow] START call=1 thread=T-worker-A |
这里 callback 仍然没有重叠,但后续调用可以换到另一个 worker。
所以默认串行保证的是:
1 | 同一个 Subscription 同一时刻只执行一个 callback |
不是:
1 | 这个 Subscription 永远绑定某个固定 OS thread |
如果业务代码使用 thread-local 状态或假设 callback 永远在线程 A 上执行,就会得到错误模型。
9.5 什么场景适合 MultiThreadedSpinner
适合:
- Node 有多个相互独立的 Subscriber/Timer/Service callback;
- 某些 callback 会偶尔耗时,但不希望拖住其它 callback;
- main thread 本身只需要等待 ROS shutdown;
- 共享状态已经有明确同步策略。
不应该仅为了“线程更多”直接切换:
- callback 大量访问同一个非线程安全对象;
- 逻辑依赖不同 callback 之间严格执行顺序;
- 实际瓶颈是设备锁、单一硬件总线或单一状态机,增加 worker 也无法增加有效并发。
本节小结:
MultiThreadedSpinner(N)给一个 CallbackQueue 提供N个 worker。- 不同 Subscription 的 callback 可以并发。
- “可以并发”不等于“必然同时执行”。
- 同一 Subscription 默认仍有额外串行约束,不能只看 worker 数。
- 串行 callback 也不等于固定在线程上执行,worker 可以在不同调用之间发生变化。
10. allow_concurrent_callbacks:决定“同一个 Subscription”能不能重入
MultiThreadedSpinner 只解决一个问题:
1 | CallbackQueue 有没有多个 worker? |
而另一个问题是:
1 | 同一个 SubscriptionQueue 是否允许多个 worker 同时进入 callback? |
这由:
1 | SubscribeOptions::allow_concurrent_callbacks |
决定。
10.1 默认值为什么是 false
SubscribeOptions 默认:
1 | SubscribeOptions() |
这个值最终传给:
1 | SubscriptionQueue( |
SubscriptionQueue::ready():
1 | if (allow_concurrent_callbacks_) |
SubscriptionQueue::call() 中也会再次保护:
1 | if (!allow_concurrent_callbacks_) |
因此默认情况下,如果一个 worker 已经在执行这个 subscription 的 callback,另一个 worker 不能同时执行下一条消息。
10.2 四个 worker,默认仍然串行
只发送 slow topic:
1 | rostopic pub -r 1 \ |
Node:
1 | roslaunch ros1_comm_lab spinner_lab.launch \ |
实际日志:
1 | [slow] START call=1 thread=T-worker-A |
最重要的是时间关系:
1 | START 1 |
始终没有出现:
1 | START 2 |
跑到:
1 | END 1 |
之前。
所以即使有 4 个 Spinner worker:
1 | 同一 Subscription |
仍然保持 callback 非重入。
10.3 打开 true 后,同一个 Subscription 真正并发
重新启动:
1 | roslaunch ros1_comm_lab spinner_lab.launch \ |
仍然以 1 Hz 发送 /comm_lab/slow。
实际日志:
1 | [slow] START call=1 thread=T-worker-A |
这次证据非常直接:
1 | call=1 尚未 END |
所以不是简单的“thread id 不一样”,而是执行时间发生了真实重叠。
10.4 true 只是允许并发,不负责制造线程
需要特别区分:
1 | allow_concurrent_callbacks=true |
只取消同一 SubscriptionQueue 的串行限制。
它不会自己创建 worker。
因此:
1 | ros::spin() |
依然只有一个 callback 执行线程,实际仍然串行。
同一个 Subscription 真正形成并发,需要同时满足:
1 | 多个可用 Spinner worker |
10.5 什么场景适合打开
更适合:
- 每条消息可以独立处理;
- callback 本身无状态,或共享状态已经线程安全;
- 单条处理较重,希望利用多个 CPU core;
- 不依赖 callback 的完成顺序。
谨慎或保持 false:
- 电机/执行器控制命令需要顺序处理;
- 协议解析依赖前一帧状态;
- callback 修改同一个状态机;
- callback 访问非线程安全 SDK/设备句柄;
- 后一条消息的业务含义依赖前一条已经处理完成。
还有一个容易忽略的后果:一旦允许同一 Subscription 并发,接收顺序不能再自动推导为完成顺序。例如:
1 | msg1 callback 处理 200 ms |
可能出现:
1 | msg1 START |
所以 allow_concurrent_callbacks=true 不只是性能选项,它改变了业务代码能依赖的并发与完成顺序条件。
本节小结:
MultiThreadedSpinner决定是否存在多个 worker;allow_concurrent_callbacks决定同一 Subscription 是否允许重入。- 默认
false时,即使有 4 个 worker,同一 Subscription 仍然串行。 - 打开
true后,只要同时有多个 ready callback 和多个 worker,就可能真正并发。 - 开启后必须重新检查共享状态、执行顺序、对象生命周期和设备访问线程安全。
11. AsyncSpinner:关键区别是 start() 返回,main thread 被释放出来
AsyncSpinner 与 MultiThreadedSpinner 都可以提供多个 callback worker,但调用方式不同。
11.1 基本用法
1 | ros::AsyncSpinner spinner(2); |
start() 创建 worker 后返回,因此当前线程可以继续执行其它工作。
而:
1 | ros::MultiThreadedSpinner spinner(2); |
内部启动 AsyncSpinner 后,调用线程会进入:
1 | ros::waitForShutdown(); |
所以二者不是“一个同步,一个异步”这么简单,更准确的区别是:
1 | MultiThreadedSpinner::spin() |
11.2 worker 数量与 callAvailable()/callOne()
Noetic:
1 | bool use_call_available = thread_count_ == 1; |
因此:
1 | AsyncSpinner(1) |
构造:
1 | ros::AsyncSpinner spinner(0); |
时,Noetic 会尝试使用 boost::thread::hardware_concurrency();若仍得到 0,则退化为 1。教学实验中显式写出线程数更容易判断行为。
11.3 为什么“main thread 空出来”会扩大同步责任
假设:
1 | AsyncSpinner worker |
这时即使只有:
1 | AsyncSpinner(1) |
进程里也至少存在:
1 | callback worker |
两个可能同时访问共享状态的执行上下文。
所以 AsyncSpinner(1) 虽然 callback 彼此串行,不代表整个进程是单线程业务模型。
11.4 适用场景
适合:
- main thread 还有自己的生命周期管理;
- main thread 运行设备循环、状态机或其它非 callback 工作;
- 希望 callback 处理与 main loop 解耦;
- 使用 custom CallbackQueue,为某个 queue 单独启动 worker。
不应该误解为:
1 | 用了 AsyncSpinner |
恰恰相反,它通常意味着需要更明确地定义 main thread 与 callback worker 的共享数据边界。
本节小结:
AsyncSpinner::start()启动 worker 后立即返回,main thread 可以继续做其它事情。AsyncSpinner(1)的 callback 仍然串行,但 main thread 与 worker 之间已经存在并发。AsyncSpinner(N>1)与allow_concurrent_callbacks的组合决定同一 Subscription 是否有并发机会。- 它适合需要把 ROS callback 和主程序循环解耦的 Node。
12. SpinnerMonitor:为什么不能靠“多调用几次 ros::spin()”制造并发
spinner.cpp 中的 SpinnerMonitor 会跟踪某个 CallbackQueue 当前由哪类 Spinner 消费。
单线程 Spinner 会记录当前 thread id;多线程 Spinner 则记录为多线程模式。
它要保护的是:
1 | SingleThreadedSpinner 对 callback 顺序的基本假设 |
因此不能把:
1 | 线程 A -> ros::spin() |
当成一种正常的“手工 MultiThreadedSpinner”。
需要并行时应该明确选择:
1 | MultiThreadedSpinner |
这样线程模型、queue 边界和共享状态责任才是显式的。
本节小结: SpinnerMonitor 不是执行 callback 的 worker,而是防止同一 CallbackQueue 被不兼容的 Spinner 模型同时消费;并发应该通过明确的 Spinner/Queue 设计建立,而不是叠加多个 ros::spin()。
13. Custom CallbackQueue:隔离的不是 Topic,而是 callback 调度域
多个 worker 仍然可以共同消费同一个 global CallbackQueue。
如果需要更明确的隔离,可以把不同 callback 放进不同 CallbackQueue。
13.1 NodeHandle 怎样选择 queue
实验代码:
1 | ros::CallbackQueue driver_queue; |
随后:
1 | fast_subscriber_ = global_nh.subscribe(...); |
使用 global CallbackQueue;
1 | driver_subscriber_ = driver_nh.subscribe(...); |
使用 driver_queue。
Noetic NodeHandle::subscribe():
1 | if (ops.callback_queue == 0) |
因此一个进程里可以有多个独立 queue。
13.2 每个 queue 再决定自己的 Spinner
当前 custom_queue_lab:
1 | ros::AsyncSpinner driver_spinner(1, &driver_queue); |
执行模型:
1 | /comm_lab/fast |
这里不是“一个 queue 加两个线程”,而是:
1 | 两个独立 queue |
13.3 实测:driver 阻塞 2 秒,global callback 继续执行
启动:
1 | roslaunch ros1_comm_lab custom_queue_lab.launch \ |
另两个终端:
1 | rostopic pub -r 0.2 \ |
1 | rostopic pub -r 5 \ |
实际日志脱敏后:
1 | [global] EVENT call=8 thread=T-main |
driverCallback() 在 T-driver 中阻塞约 2 秒期间,T-main 上的 global callback 仍持续运行。
这证明 custom queue 建立的是独立调度域:
1 | CallbackQueue A 阻塞 |
前提是它们确实由不同的执行线程消费。
13.4 Custom Queue 适合解决什么问题
适合:
- 一组 callback 有特殊延迟特性,希望和其它 callback 隔离;
- 驱动控制 callback 希望固定单 worker 串行;
- 普通状态/监控 callback 希望使用另一套 worker;
- 一个组件需要明确掌握自己的 CallbackQueue 生命周期和线程数。
它不能自动解决:
1 | queue A callback |
两个 queue 只是隔离调度,不是隔离内存。
本节小结:
NodeHandle::setCallbackQueue()可以把一组 callback 放进 custom CallbackQueue。- 不同 queue 可以分别配置自己的 Spinner 和 worker 数。
- 实测中 driver queue 阻塞 2 秒时,global queue 仍持续处理 callback。
- Custom CallbackQueue 解决的是调度隔离,不会自动解决跨 queue 的共享数据竞争。
14. 把“串行/并发”拆成四个层次,才不会混淆
到这里已经可以把几个容易混在一起的概念分开。
14.1 Spinner worker 数量
回答:
1 | 这个 CallbackQueue 有多少执行线程可以取工作? |
例如:
1 | ros::spin() -> 1 |
14.2 CallbackQueue
回答:
1 | 这些 callback 属于哪个调度域? |
不同 custom queue 可以拥有不同的消费线程。
14.3 SubscriptionQueue
回答:
1 | 某一个 subscription 已经到达、尚未被业务 callback 消费的消息放在哪里? |
它还负责维护这个 subscription 的默认非重入约束。
14.4 allow_concurrent_callbacks
回答:
1 | 同一个 Subscription 是否允许多个 callback 同时进入? |
因此:
1 | MultiThreadedSpinner = 有并发能力 |
不能直接推导为:
1 | 所有 callback = 全部并发 |
更准确的判断链是:
1 | 先看 callback 属于哪个 CallbackQueue |
本节小结: Spinner、CallbackQueue、SubscriptionQueue 和 allow_concurrent_callbacks 分别控制不同层次;判断并发时必须逐层分析,不能只看“线程数”。
15. 对驱动 Node 更实用的线程模型:ROS callback 与设备 I/O 主动解耦
本章的目标不是提前实现完整 Driver Architecture,而是先建立执行域意识。
可以先把 Node 看成三类线程:
1 | roscpp Poll/network thread |
15.1 为什么不建议把长时间设备阻塞直接放进 callback
如果 callback 中:
1 | serial.read(timeout = 2 s) |
那么至少有一个 Spinner worker 会被占住 2 秒。
ros::spin() 下,这可能拖住整个 global CallbackQueue 的用户 callback。
MultiThreadedSpinner 下,别的 worker 仍可工作,但:
- 该阻塞本身不会更快;
- worker 是有限资源;
- callback 与其它线程可能开始同时访问驱动状态;
- 设备句柄如果本身只允许串行访问,增加 worker 没有意义。
15.2 更稳妥的基础方向
后续驱动章节可以沿这个边界实现:
1 | ROS callback |
这种设计把“ROS callback 调度”和“设备阻塞 I/O”分开。
15.3 哪些共享状态必须重新检查
从单线程 Spinner 切到多线程或 AsyncSpinner 后,应重新检查:
1 | mutex |
尤其不要在持有一个大锁时做长时间设备 I/O,否则表面上虽然用了多个 worker,业务仍会被同一把锁重新串行化,甚至产生死锁风险。
本节小结:
- Spinner worker 和设备 I/O thread 是不同执行域。
- 多线程 Spinner 只能增加 callback 执行机会,不能让阻塞设备操作自动变快。
- 驱动 callback 更适合短执行并投递命令,设备线程负责真正阻塞 I/O。
- 一旦引入多线程,就必须显式设计共享状态、锁和生命周期。
16. 推荐的 F12 / GDB 源码阅读顺序
本章源码主线仍然保持一条,不因为增加实验而扩成源码百科。
第一条主链:
1 | Subscription::handleMessage() |
多线程分支:
1 | MultiThreadedSpinner::spin() |
同一 Subscription 并发约束:
1 | SubscribeOptions::allow_concurrent_callbacks |
推荐断点:
| 断点 | 要证明什么 |
|---|---|
Subscription::handleMessage |
网络数据已经进入 subscription 层 |
CallbackQueue::addCallback |
工作什么时候进入 CallbackQueue |
SingleThreadedSpinner::spin |
ros::spin() 最终使用哪种 Spinner |
AsyncSpinnerImpl::threadFunc |
多 worker 的实际执行入口 |
CallbackQueue::callAvailable |
单 worker 如何消费一批 callback |
CallbackQueue::callOne |
多 worker 如何一次取一个 ready callback |
CallbackQueue::callOneCB |
CallbackInterface::call() 的统一调度点 |
SubscriptionQueue::call |
消息出队、反序列化与 callback 并发锁在哪里发生 |
SpinnerLab::slowCallback |
最终用户 callback 的线程和调用栈 |
GDB:
1 | info threads |
如果停在 slowCallback(),重点沿栈向上确认:
1 | slowCallback() |
本节小结: 源码阅读始终围绕“callback 如何从入队走到真实执行线程”这条主线;GDB 的价值是把静态调用链与实际线程栈对应起来。
17. 用 rqt_console 看时序时,应该观察什么
如果 Docker GUI 已配置,可运行:
1 | rqt_console |
实验日志统一使用:
1 | [slow] |
可以过滤观察:
1 | slow START/END 之间 fast 是否继续出现 |
rqt_graph 能看到 Node/Topic 连接关系,但看不到 CallbackQueue、SubscriptionQueue 或 Spinner worker,因此不能用它证明线程并发。
本节小结: rqt_console 适合看 callback 时序证据;rqt_graph 适合看 ROS Graph,不应把两者承担的证据类型混在一起。
18. CallbackQueue、Spinner 与 callback 并发模型统一对比
前面的源码和实测已经足够把常见方式放进同一套坐标系。
18.1 API 与线程行为对比
| 模式 | 默认 CallbackQueue | callback worker | 调用线程是否被持续占用 | 不同 Subscription | 同一 Subscription 默认 | allow_concurrent=true 后 |
|---|---|---|---|---|---|---|
ros::spin() |
global | 1 | 是 | 串行 | 串行 | 仍串行 |
ros::spinOnce() |
global | 当前调用线程 | 否,处理一轮后返回 | 串行 | 串行 | 仍串行 |
SingleThreadedSpinner |
global 或指定 queue | 1 | 是 | 串行 | 串行 | 仍串行 |
MultiThreadedSpinner(N>1) |
global 或指定 queue | N | spin() 调用者等待 shutdown |
可并发 | 串行 | 可并发 |
AsyncSpinner(1) |
global 或指定 queue | 1 | 否,start() 返回 |
串行 | 串行 | 实际仍串行 |
AsyncSpinner(N>1) |
global 或指定 queue | N | 否,start() 返回 |
可并发 | 串行 | 可并发 |
| Custom CallbackQueue | 自定义 | 由该 queue 的 Spinner 决定 | 取决于所选 Spinner | 可形成独立调度域 | 仍看该 Subscription | 仍看 worker 数与配置 |
表中的“可并发”都表示具备并发条件,不表示每次一定同时运行。
18.2 选择时先问这几个问题
| 场景 | 更合适的起点 | 原因 |
|---|---|---|
| callback 很短、Node 简单 | ros::spin() |
执行模型最容易推理 |
| 程序本身已有周期主循环 | spinOnce() |
callback 处理点由主循环控制 |
| 多个独立 callback,某些会耗时 | MultiThreadedSpinner |
不同 callback 可由不同 worker 推进 |
| main thread 还要运行其它逻辑 | AsyncSpinner |
start() 返回,不占住 main thread |
| 一组 callback 需要与其它 callback 隔离 | Custom CallbackQueue | 建立独立调度域 |
| 同一 Topic 每条任务完全独立、计算重 | 多 worker + 评估 allow_concurrent_callbacks=true |
同一 Subscription 可利用多个 worker |
| 顺序敏感控制/协议状态机 | 同一 Subscription 保持默认串行 | 避免重入与完成顺序变化 |
| 阻塞设备 I/O | 独立设备线程 | 不让 Spinner worker 长时间被设备占用 |
这里没有“线程越多越好”的统一答案。选择依据应是:
1 | callback 是否独立 |
18.3 一句话区分几个核心对象
1 | CallbackQueue |
18.4 实测证据与结论对应关系
| 实测 | 已确认结论 |
|---|---|
spin 下 slow 阻塞期间 fast 不执行,slow 结束后 fast 批量继续 |
单线程 Spinner 中不同 Subscription 仍互相阻塞 |
multi(2) 下 slow 阻塞期间 fast 在另一 worker 持续执行 |
不同 Subscription 可以并发 |
multi(4) + allow=false 中 slow 始终 START -> END -> START |
同一 Subscription 默认不重入 |
multi(4) + allow=true 中多个 slow START 在前一个 END 前出现 |
同一 Subscription 已真实并发 |
| custom queue 中 driver 阻塞时 global 持续执行 | 独立 CallbackQueue + 独立 Spinner 可以隔离调度阻塞 |
这五组结果正好覆盖本章最重要的五个线程判断。
本节小结: 判断 roscpp callback 并发不能只问“用了几个线程”,而要同时看 CallbackQueue 边界、Spinner worker 数、SubscriptionQueue 约束、allow_concurrent_callbacks 和业务共享状态。
19. 本章最终模型
阶段 08 解决:
1 | 一条 Topic message 怎样通过 TCPROS 进入 Subscriber 进程 |
阶段 09 继续解决:
1 | 消息已经进入进程以后,怎样被调度为一次真正的用户 callback |
最终主链:
1 | TCP socket |
现在应能够解释:
1 | 1. 为什么 ros::spin() 下 slow callback 会拖住 fast callback。 |
阶段 09 的核心不是记住几个 Spinner 类名,而是建立下面的判断方式:
1 | 消息到了没有? |
下一章进入 Unit Test、rostest、rqt 与 rosbag,把 06~09 已经建立的运行机制转成可重复的测试和调试证据。
本节小结: 第 09 章最终建立的是“消息队列、调度队列、执行线程、Subscription 并发约束和驱动 I/O 线程”之间的完整边界,而不是单独记忆某个 Spinner API。
参考源码与官方资料
- ROS1 Noetic
spinner.cpp:https://github.com/ros/ros_comm/blob/noetic-devel/clients/roscpp/src/libros/spinner.cpp - ROS1 Noetic
callback_queue.cpp:https://github.com/ros/ros_comm/blob/noetic-devel/clients/roscpp/src/libros/callback_queue.cpp - ROS1 Noetic
subscription.cpp:https://github.com/ros/ros_comm/blob/noetic-devel/clients/roscpp/src/libros/subscription.cpp - ROS1 Noetic
subscription_queue.cpp:https://github.com/ros/ros_comm/blob/noetic-devel/clients/roscpp/src/libros/subscription_queue.cpp - ROS1 Noetic
subscribe_options.h:https://github.com/ros/ros_comm/blob/noetic-devel/clients/roscpp/include/ros/subscribe_options.h - ROS1 Noetic
node_handle.cpp:https://github.com/ros/ros_comm/blob/noetic-devel/clients/roscpp/src/libros/node_handle.cpp - ROS1 Noetic
init.cpp:https://github.com/ros/ros_comm/blob/noetic-devel/clients/roscpp/src/libros/init.cpp - roscpp CallbackQueue API:
https://docs.ros.org/en/noetic/api/roscpp/html/classros_1_1CallbackQueue.html - roscpp Spinner API:
https://docs.ros.org/en/noetic/api/roscpp/html/spinner_8h.html
 微信
- 支付寶