用 Git Submodule + Sparse Checkout 管理 RT-Thread:内核、BSP、第三方库与业务代码分层实践
摘要:用 Submodule 锁定 RT-Thread 与第三方依赖版本,用 Sparse Checkout 精简工作区,并保持业务代码、构建配置和上游同步边界清晰。
@[toc]
嵌入式固件项目维护时间一长,仓库很容易逐渐变成“一份大拷贝”:RTOS 内核、芯片厂商库、BSP、第三方组件和产品业务代码全部堆在一起。短期看最省事,长期却会暴露几个典型问题:依赖来源难追踪、升级时 diff 巨大、多个项目重复保存相同代码、业务代码和基础设施边界越来越模糊。
更适合长期维护的做法,不是简单把目录删掉或拆得越碎越好,而是把三个问题分别交给三个机制处理:
- Git Submodule:这个依赖来自哪个仓库,产品当前锁定哪个 commit;
- Git Sparse Checkout:一个已经存在的仓库,在当前工作区实际展开哪些目录;
- Kconfig /
rtconfig.h/ SCons / IDE 工程:哪些功能和源文件最终参与构建。
这三个机制分别控制“版本边界”“工作区边界”和“构建边界”。只有先把它们分开,RT-Thread、BSP、第三方库和产品代码的关系才不会混在一起。
先建立正确的心智模型:版本、工作树和构建是三件事
Git Submodule 和 Sparse Checkout 经常同时出现,但它们解决的问题完全不同。
| 机制 | 主要解决的问题 | 是否改变上游仓库内容 | 是否锁定依赖版本 |
|---|---|---|---|
| Git Submodule | 依赖来自哪里,主仓库引用哪个提交 | 否 | 是 |
| Git Sparse Checkout | 当前工作树展开哪些已跟踪路径 | 否 | 否 |
| Kconfig / SCons / IDE | 哪些功能和源文件参与构建 | 不涉及 | 不涉及 |
Submodule 在超级项目(superproject)中通过 gitlink 记录子模块应当处于哪个 commit。.gitmodules 则保存子模块路径、URL,以及可选的默认跟踪分支等信息。普通 git submodule update 的目标是恢复超级项目记录的那个 commit;只有显式使用 --remote 时,才会根据子模块远端跟踪分支寻找新的目标提交。
Sparse Checkout 的作用则是把工作树缩减为已跟踪文件的一个子集。它不会生成一份“裁剪后的 RT-Thread 仓库”,也不会改写 commit 历史。被隐藏的目录仍然属于当前 RT-Thread revision,只是不出现在本地工作树中。
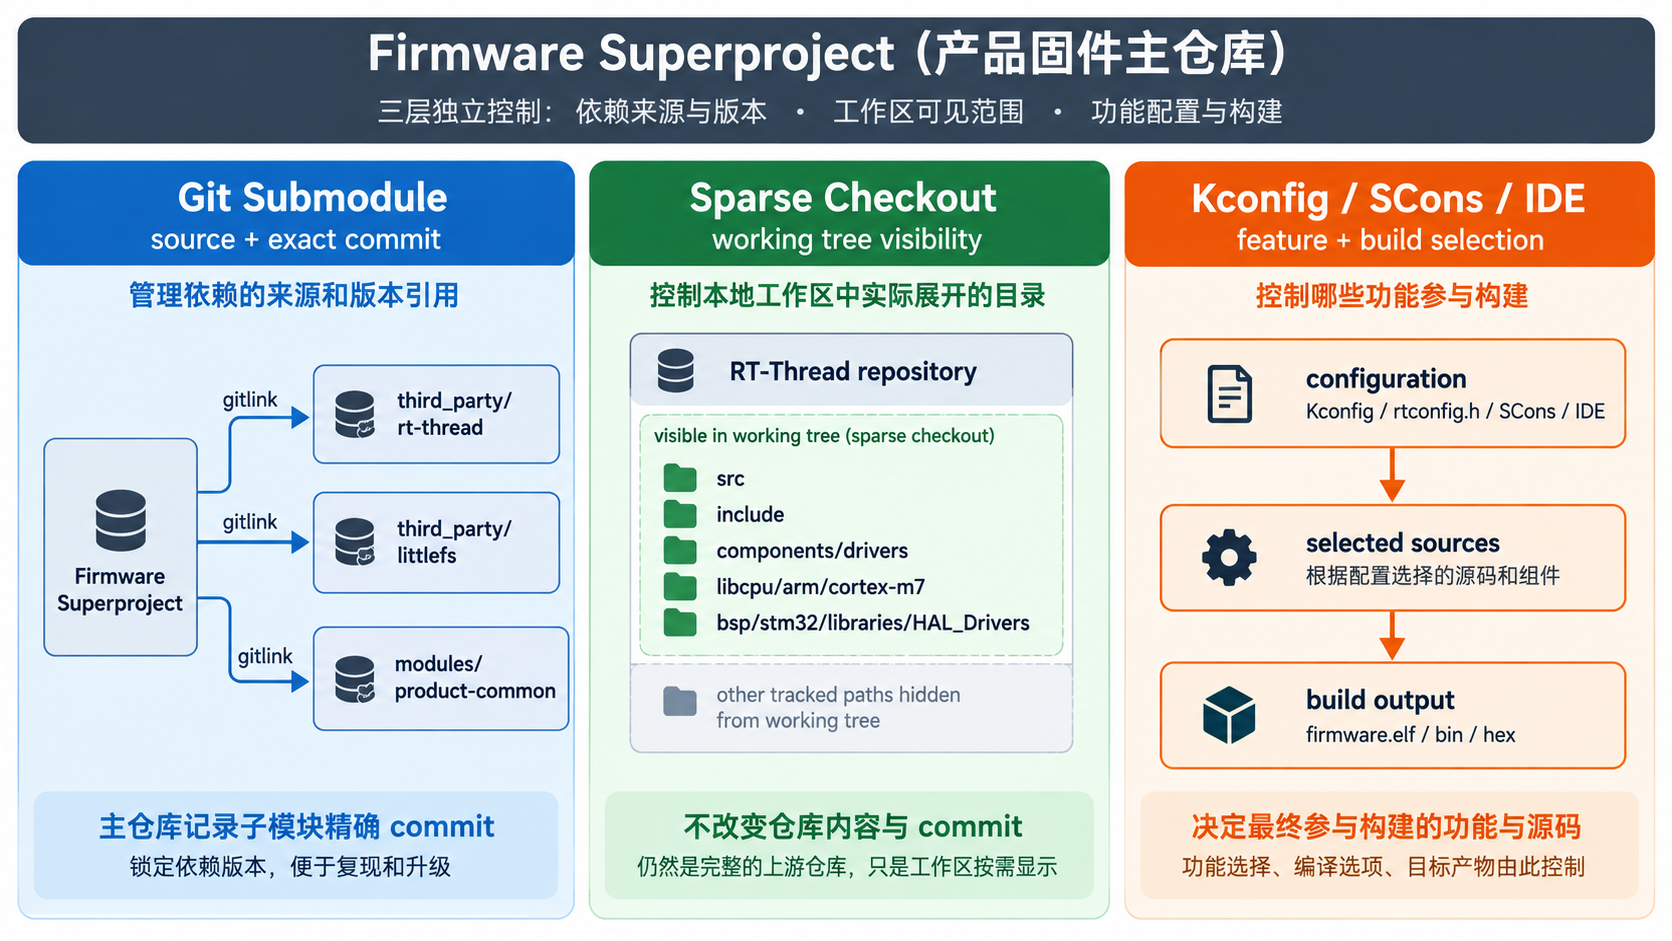
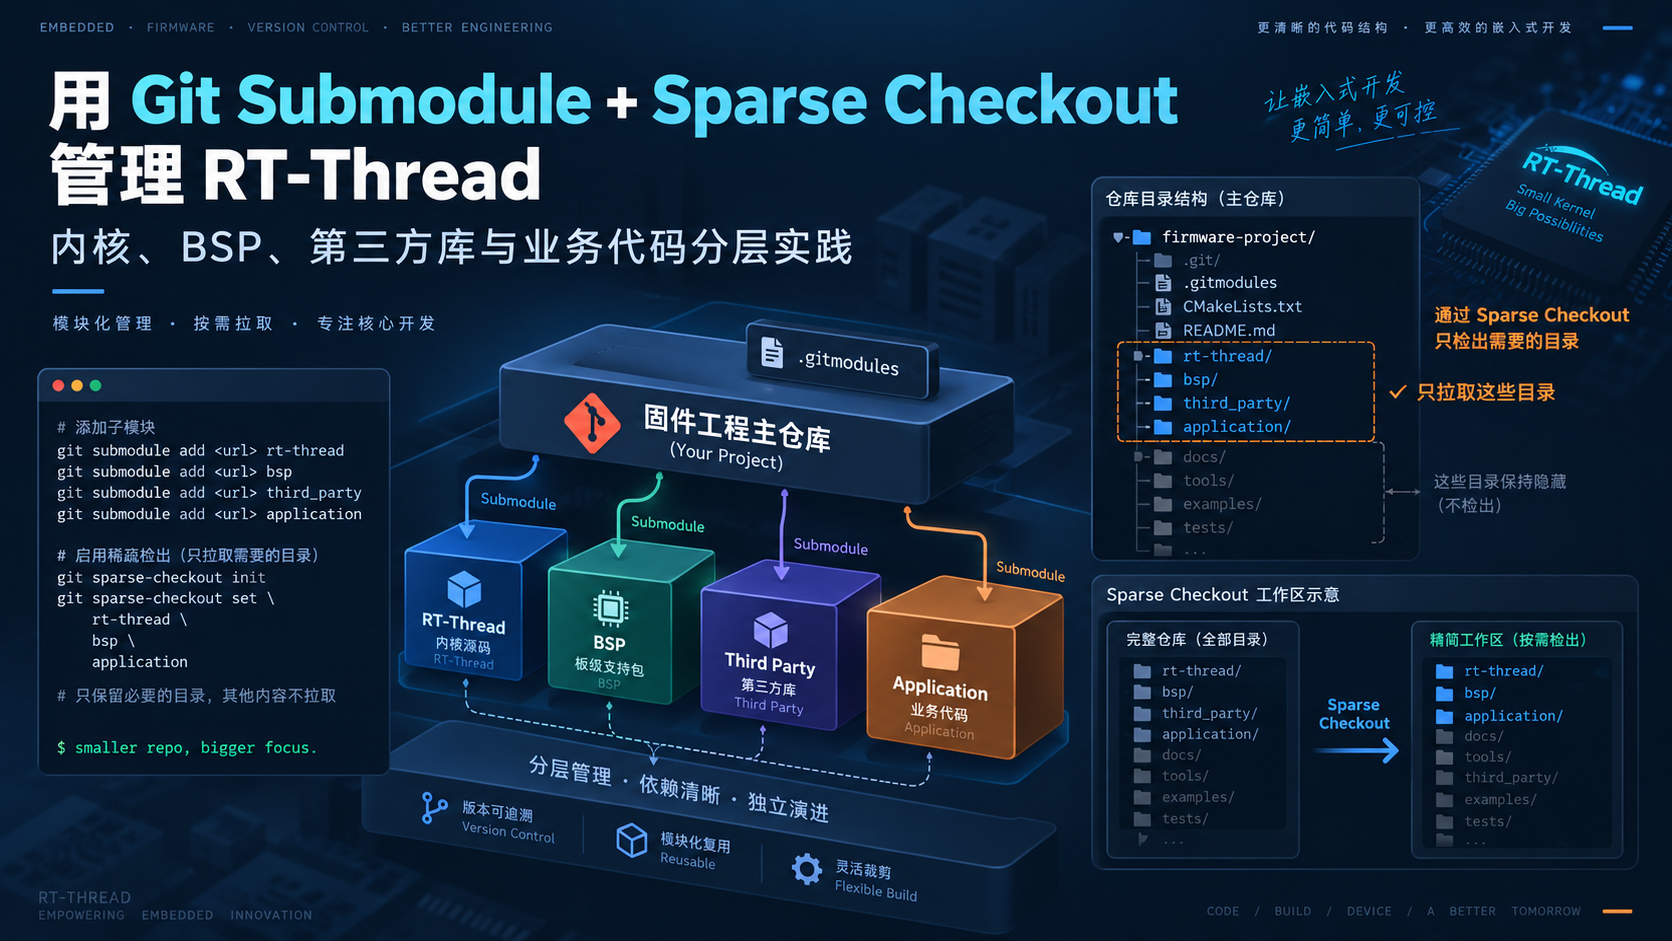
图中最重要的是三条边界:
- 主仓库通过 gitlink 锁定 RT-Thread、littlefs 或团队公共模块的精确 commit;
- RT-Thread 子模块仍然是完整 Git 仓库,只是在工作区按需展开
src、include、驱动、CPU 端口和当前 BSP 所需目录; - 最后由 Kconfig、
rtconfig.h、SCons 或 IDE 工程决定真正参与编译的源文件。
因此,Sparse Checkout 不能代替 Kconfig,Kconfig 也不能代替 Submodule。三者职责不同。
主仓库首先要明确“谁拥有这段代码”
建议让产品主仓库只直接维护本产品真正拥有的内容,例如:
1 | firmware-project/ |
这里有一个比“目录是否很大”更重要的判断标准:是否具有独立生命周期和独立版本边界。
只服务于当前产品、修改通常需要和当前产品一起提交的代码,继续留在主仓库最简单;真正会被多个产品复用、拥有独立仓库和发布节奏的公共模块,才适合拆成 Submodule。
外部 RTOS、文件系统、算法库等依赖则天然适合使用 Submodule,因为产品需要明确回答“当前到底基于哪个版本”。
把 RT-Thread 作为 Submodule 引入
以官方 RT-Thread 仓库为例,可以把它放到 third_party/rt-thread:
1 | git submodule add -b master \ |
执行后,主仓库会生成或更新 .gitmodules:
1 | [submodule "third_party/rt-thread"] |
然后提交主仓库:
1 | git add .gitmodules third_party/rt-thread |
需要特别理解 branch = master 的含义。它是 git submodule update --remote 等操作使用的默认远端跟踪分支,并不意味着普通初始化时会自动追到 master 最新提交。
普通恢复命令仍然是:
1 | git submodule update --init --recursive |
在默认 checkout 更新策略下,Git 会把子模块检出到超级项目记录的 commit,通常表现为 detached HEAD。这个行为恰恰保证了产品依赖可复现。
可以用下面的命令确认当前引用:
1 | git submodule status |
再用 Sparse Checkout 缩小 RT-Thread 工作区
RT-Thread 主仓库同时包含 bsp、components、include、libcpu、src、tools 等大量目录。对于单一 STM32 Cortex-M7 项目,日常开发通常不需要把其他架构、其他厂商和大量无关 BSP 全部展开到 IDE 文件树中。
对子模块启用 cone mode:
1 | git -C third_party/rt-thread sparse-checkout init --cone |
然后按当前项目需要设置目录。例如:
1 | git -C third_party/rt-thread sparse-checkout set \ |
当前稀疏集合可以直接查看:
1 | git -C third_party/rt-thread sparse-checkout list |
Git 的 cone mode 以目录为主要输入,并会保留所需祖先目录中的必要文件。对 RT-Thread 这类目录层级明确的大型源码仓库,比手工维护复杂的 gitignore 风格规则更适合。
如果后续启用了 DFS、网络栈或其他组件,再扩展目录集合即可:
1 | git -C third_party/rt-thread sparse-checkout add \ |
需要强调:Sparse Checkout 只决定工作区看到什么,不是“删除源码”,也不是“关闭功能”。真正决定组件是否参与编译的仍然是 Kconfig、rtconfig.h 和 SCons 构建规则。
因此,把无关目录加入 .gitignore 不能达到相同效果;直接删除 RT-Thread 中暂时不用的目录更不可取,因为那会变成真实源码修改,给后续上游同步制造大量无意义差异。
稀疏目录策略必须进入主仓库,而不是留在某台电脑里
Sparse Checkout 的配置属于本地 Git 工作区状态,不会像普通源码文件一样自然地随产品主仓库传播。团队项目不能依赖每个开发者手工输入一串路径。
更稳妥的方式,是把项目需要的 RT-Thread 目录保存成普通配置文件,例如:
1 | tools/dependency/rtthread_sparse_paths.txt |
内容只保留目录清单:
1 | src |
再提供一个很薄的初始化脚本:
1 | #!/usr/bin/env python3 |
这样,新开发环境和 CI 的入口就能稳定为:
1 | git clone <firmware-project-url> |
也可以在 clone 时初始化子模块:
1 | git clone --recurse-submodules <firmware-project-url> |
但无论使用哪种 clone 方式,Sparse Checkout 目录集合仍然应由主仓库中的配置显式恢复,而不是假定其他电脑会继承本机 Git 状态。
第三方库和团队公共模块沿用同一套边界
除了 RT-Thread,littlefs、压缩算法、Bootloader 公共库、诊断库等外部依赖,也可以分别作为 Submodule:
1 | git submodule add \ |
主仓库最终可以形成这样的关系:
1 | firmware-project/ |
普通小型依赖没有必要为了形式统一而继续做 Sparse Checkout。只有依赖本身很大,而且项目长期稳定地只使用少数目录时,才值得增加这一层工作区裁剪。
如果某个组件本来通过 RT-Thread package 机制管理,也应先确定唯一依赖所有者。不要同时让 package 系统和 Submodule 管理同一份源码,否则版本来源会变得不清楚。
“恢复产品版本”和“主动升级依赖”必须分开
日常开发首先做的是恢复产品已经锁定的 revision:
1 | git pull |
这条路径的目标是复现主仓库已经提交并验证过的依赖组合。
主动升级 RT-Thread 则是另一件事。维护者可以显式执行:
1 | git submodule update --remote third_party/rt-thread |
然后检查主仓库中 gitlink 是否发生变化:
1 | git status |
完成构建和项目回归后,再提交新的子模块引用:
1 | git add third_party/rt-thread |
这一步不能省略。否则开发者本地虽然已经把 RT-Thread 拉到了新版本,但超级项目没有记录新的 gitlink,其他开发者和 CI 仍然无法复现这个状态。
RT-Thread 需要长期维护补丁时,用 Fork + upstream
如果产品完全不修改 RT-Thread,Submodule 可以直接指向官方仓库。
如果产品需要长期维护少量内核、驱动或 BSP 补丁,更清晰的做法是维护团队 fork,把官方仓库配置成 upstream,在 fork 自己的集成分支中处理同步和补丁,再由产品主仓库锁定这个 fork 的精确 commit。
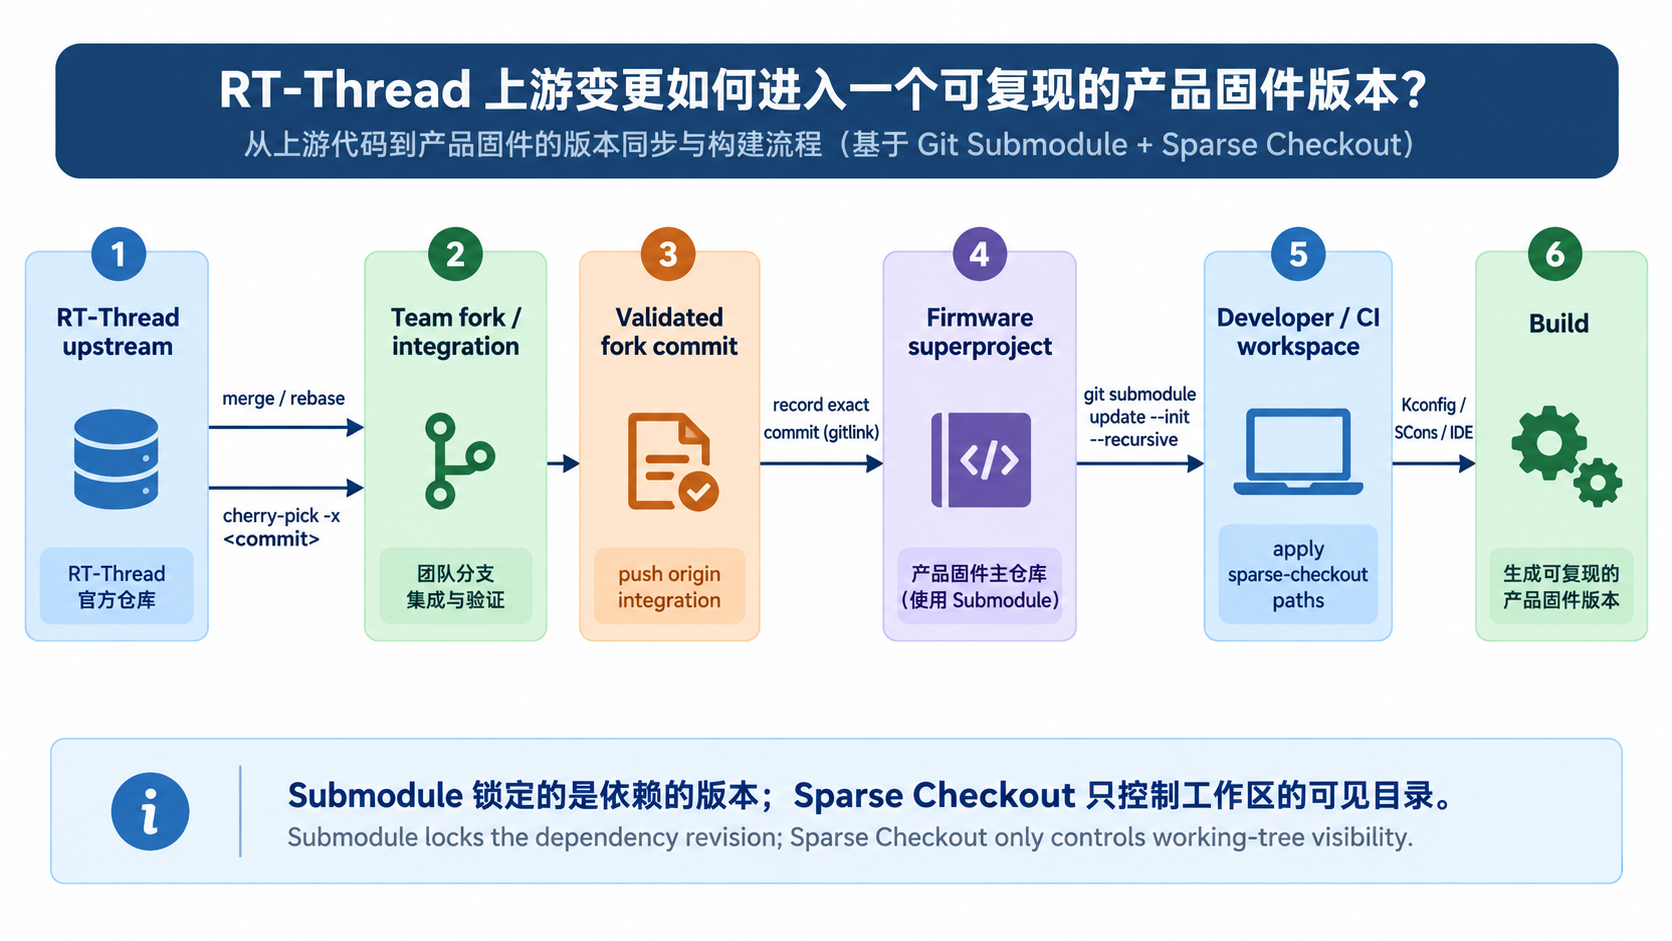
这个流程有两个非常重要的版本边界:
- RT-Thread fork 自己负责整合上游历史和团队补丁;
- 产品主仓库只负责决定当前产品到底使用 fork 中哪个 commit。
子模块可以配置成团队 fork:
1 | [submodule "third_party/rt-thread"] |
在子模块仓库中增加官方上游:
1 | git -C third_party/rt-thread remote add upstream \ |
整体跟进上游时,可以在团队 integration 分支中按约定使用 merge 或 rebase。关键不是两者谁绝对更好,而是上游同步发生在 RT-Thread fork 的仓库边界内,不要把官方同步历史和产品业务代码混在一个仓库里。
完成 fork 中的集成、验证和推送后,再回到产品主仓库更新 gitlink。
当前版本只需要一个官方修复时,用 cherry-pick 精确吸收
产品维护中经常不能整体升级 RT-Thread,只想吸收官方已经合入的一个 Bug 修复。这时可以使用 git cherry-pick。
先保证子模块工作树干净并获取官方历史:
1 | git -C third_party/rt-thread status --short |
真正应用之前先检查目标 commit:
1 | git -C third_party/rt-thread show --stat <commit-id> |
确认范围后再执行:
1 | git -C third_party/rt-thread cherry-pick -x <commit-id> |
-x 会在新提交信息中留下原始 commit 来源。对于“把公开上游修复回移到维护分支”这种场景,这个追溯信息很有价值。
发生冲突时,先处理冲突文件,然后:
1 | git -C third_party/rt-thread add <resolved-file> |
如果确认补丁不适合当前分支:
1 | git -C third_party/rt-thread cherry-pick --abort |
Sparse Checkout 下 cherry-pick 还要多检查一步
Sparse Checkout 只控制当前工作区展开哪些目录,它不能证明某个上游 commit 只修改这些目录。
因此 cherry-pick 之前至少要检查:
1 | git -C third_party/rt-thread show --stat <commit-id> |
如果补丁同时修改了当前稀疏集合之外的路径,而这些路径又需要人工解决冲突或参与验证,就先把它们临时加入工作区:
1 | git -C third_party/rt-thread sparse-checkout add \ |
补丁处理结束后,再通过项目保存的 rtthread_sparse_paths.txt 恢复标准目录集合。
这时三种操作的边界就非常清楚:
| 目标 | 操作 | 结果 |
|---|---|---|
| 恢复产品锁定版本 | git submodule update --init --recursive |
回到主仓库记录的精确 commit |
| 整体跟进上游 | fork 内 merge/rebase | 整合一段上游历史 |
| 只吸收单个修复 | git cherry-pick -x <commit-id> |
精确应用指定提交的变更 |
Sparse Checkout 不等于减少 clone 下载量
这是最容易混淆的边界之一。
Sparse Checkout 的目标是减少工作树中实际出现的文件。它不会自动等价为“少下载这些目录的 Git 对象”。如果真正目标是减少网络传输量或对象存储,还需要结合 Git 的 Partial Clone、--filter、浅克隆等机制设计。
例如:
1 | git clone --filter=blob:none <repository-url> |
Partial Clone 会改变对象获取方式;浅克隆则会限制历史可用范围。这些机制会影响离线开发、历史分析、CI 和后续维护,因此应该独立评估,而不要把它们和 Sparse Checkout 的“工作区裁剪”混为一谈。
对 RT-Thread 工程而言,Sparse Checkout 最直接的收益通常不是网络流量,而是:
- IDE 索引更聚焦;
- 全局搜索结果更干净;
- 源码导航更少被无关 BSP 和 CPU 架构干扰;
- 工程中隐藏的跨 BSP 依赖更容易暴露。
对 RT-Thread Studio、Keil 和 SCons 的影响
对构建系统而言,Sparse Checkout 之后的目录就是实际工作区。被排除的文件不存在于工作树,所以构建脚本和 IDE 工程必须只依赖当前真正展开的路径。
只要以下关系保持一致,SCons、Keil 和 RT-Thread Studio 仍然可以按正常方式工作:
- Kconfig /
rtconfig.h选择的功能; SConscript/rtconfig.py引用的源码路径;- 当前板级和 HAL 目录;
- IDE 工程中生成或引用的源文件列表。
这反而可以帮助项目暴露不正确的隐式依赖。例如某个 SConscript 无意中引用另一块板卡目录,在完整 RT-Thread 工作区里可能长期不明显;启用合理的 Sparse Checkout 后,这类问题会更快变成可见的路径错误。
因此比较稳定的职责划分是:
- Submodule:依赖来源与精确 revision;
- Sparse Checkout:本地源码可见范围;
- Kconfig /
rtconfig.h:功能配置; - SCons / RT-Thread Studio / Keil:实际构建输入与工程;
- 产品主仓库:业务代码、板级适配,以及全部依赖 revision 的组合关系。
最终落地时,把规则收敛成少数几条
长期维护的 MCU/RTOS 项目不需要把 Git 机制做得很复杂,但需要把边界固定下来:
- RT-Thread 和真正独立的外部库使用 Submodule,不再复制一份源码进产品仓库;
- 产品主仓库必须提交每个 Submodule 的精确 commit,升级依赖后必须更新 gitlink;
- RT-Thread 仓库很大时再启用 Sparse Checkout,并把目录清单和初始化脚本放进主仓库;
- 产品专用业务代码继续留在主仓库,只有独立生命周期的公共模块才拆成单独仓库;
- RT-Thread 如需长期补丁,使用 fork + upstream,让补丁历史留在 RT-Thread 自己的仓库边界内;
- CI 和新开发环境统一从“初始化 Submodule → 应用 Sparse Checkout → 配置 → 构建”这一条确定路径开始;
- Sparse Checkout 只负责工作区,不替代 Kconfig,也不等于 Partial Clone。
最终得到的不是一份“删掉大量目录的 RT-Thread”,而是一套清晰、可追溯、可复现的版本关系:产品主仓库决定组合,Submodule 锁定依赖 revision,Sparse Checkout 控制开发者需要看到什么,而 Kconfig/SCons/IDE 决定最后真正编译什么。
参考资料
- Git Submodule 官方文档:https://git-scm.com/docs/git-submodule
- Git Submodules 机制说明:https://git-scm.com/docs/gitsubmodules
- Git Sparse Checkout 官方文档:https://git-scm.com/docs/git-sparse-checkout
- Git Cherry-pick 官方文档:https://git-scm.com/docs/git-cherry-pick
- Git Clone / Partial Clone:https://git-scm.com/docs/git-clone
- Git Partial Clone 设计说明:https://git-scm.com/docs/partial-clone
- RT-Thread 官方仓库:https://github.com/RT-Thread/rt-thread
 微信
- 支付寶